Eine Geschichte. Verschiedene Perspektiven. Nachprüfbare Belege.
Ich habe MeydaNews gegründet und entwickelt, damit Leser, Journalisten und Forschende fragmentierte Berichterstattung vergleichen und ihre Recherche mit nachvollziehbaren Belegen organisieren können.
Meine RolleGründer & KI Engineer · Produkt, Daten, KI, Backend, Frontend und Cloud
UmfangEreignisse entdecken, Quellen vergleichen, Belege suchen und privat recherchieren
Das Problem
Mehr Schlagzeilen erklären noch nicht das ganze Ereignis.
Verschiedene Medien berichten über dasselbe Ereignis mit unterschiedlichen Aussagen, Schwerpunkten und Kontexten. Wer sie manuell vergleicht, muss zwischen Feeds wechseln, Originalpassagen finden und Änderungen nachverfolgen. MeydaNews verbindet diese Schritte in einem Rechercheablauf.
Das Produkt
Vom ersten Überblick zur nachvollziehbaren Recherche.
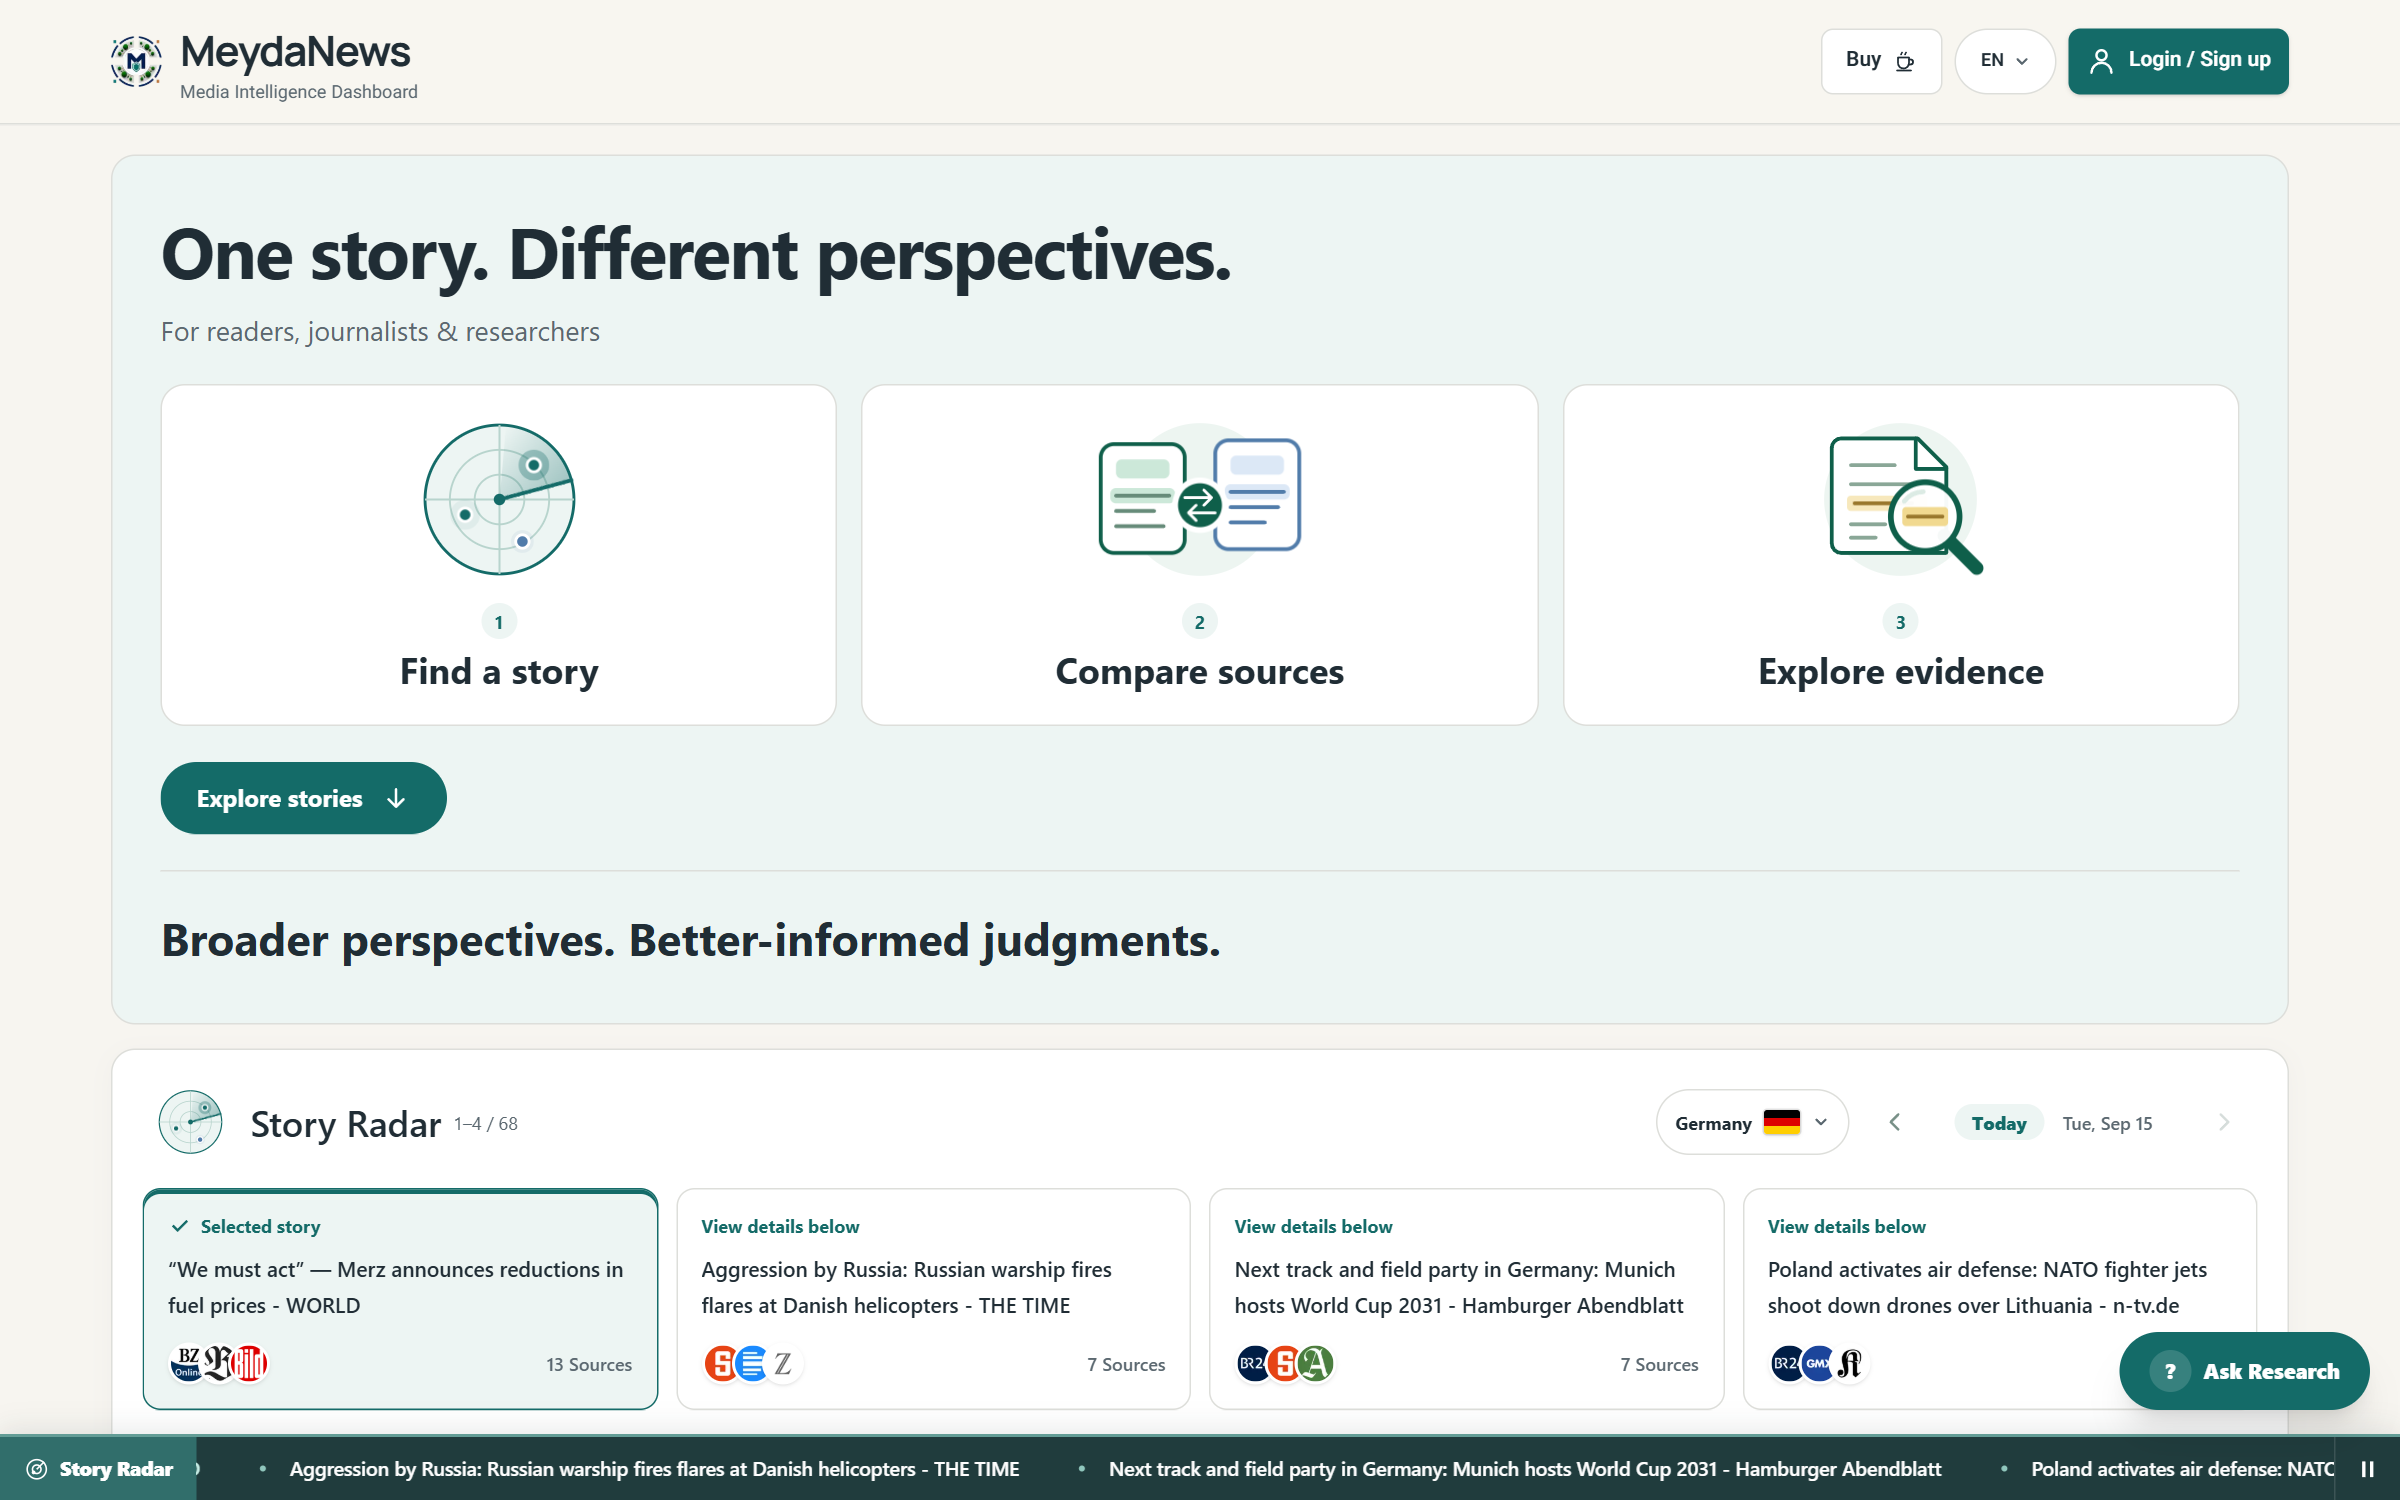
Das Produkt begann mit persischsprachigen Medien und erfasst inzwischen Berichterstattung aus Iran, Deutschland und den USA. Die Screenshots vom September 2026 zeigen die englische Oberfläche mit deutscher Berichterstattung. Jeder Screenshot lässt sich in voller Größe öffnen.
MeydaNews-Startseite: die tatsächliche Produktoberfläche zur Ereignissuche und zum Quellenvergleich.
Ein Ereignis finden und die Berichterstattung vergleichen.
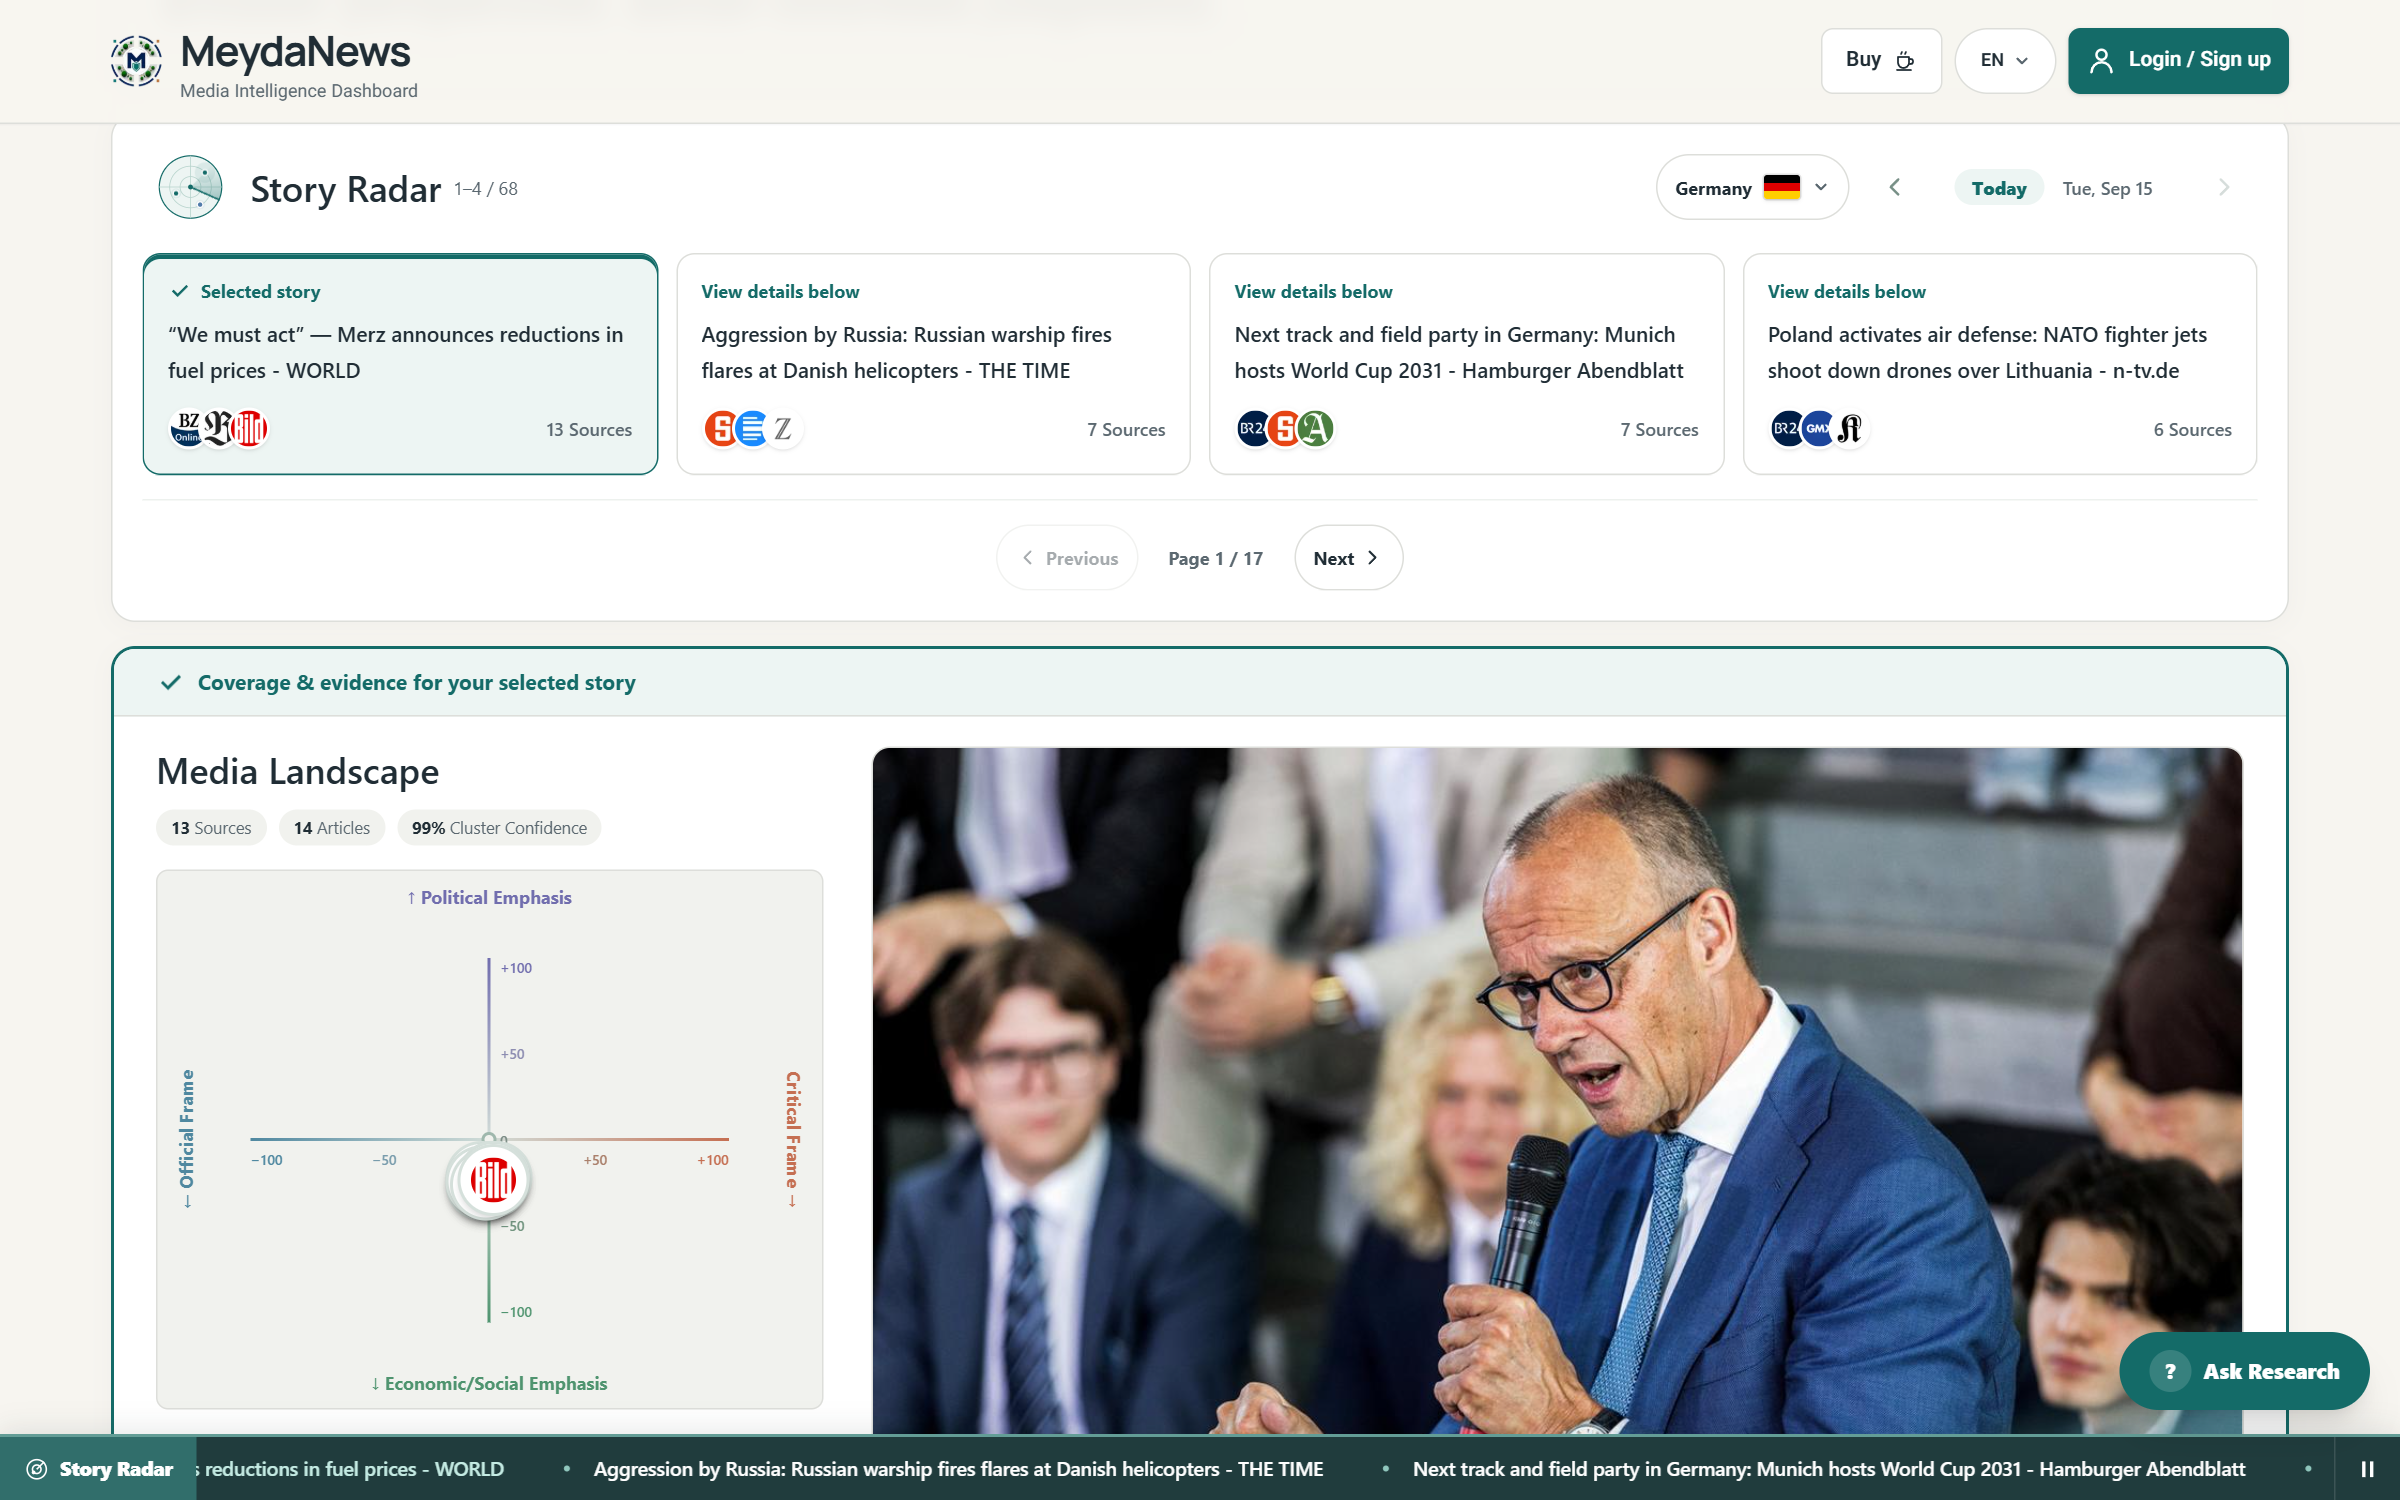
Story Radar bündelt verwandte Meldungen zu Ereignissen und zeigt die beteiligten Medien. Die Auswahl eines Ereignisses führt zu Berichten, Aussagen und der Media Landscape. Dort können Leser Unterschiede in Perspektive und Schwerpunktsetzung untersuchen.
01 / Story Radar und Media Landscape. Quellen- und Artikelzahlen beschreiben das ausgewählte Ereignis. Cluster-Konfidenz ist ein Zuordnungssignal und kein Maß für den Wahrheitsgehalt.
Originalbelege jederzeit prüfen können.
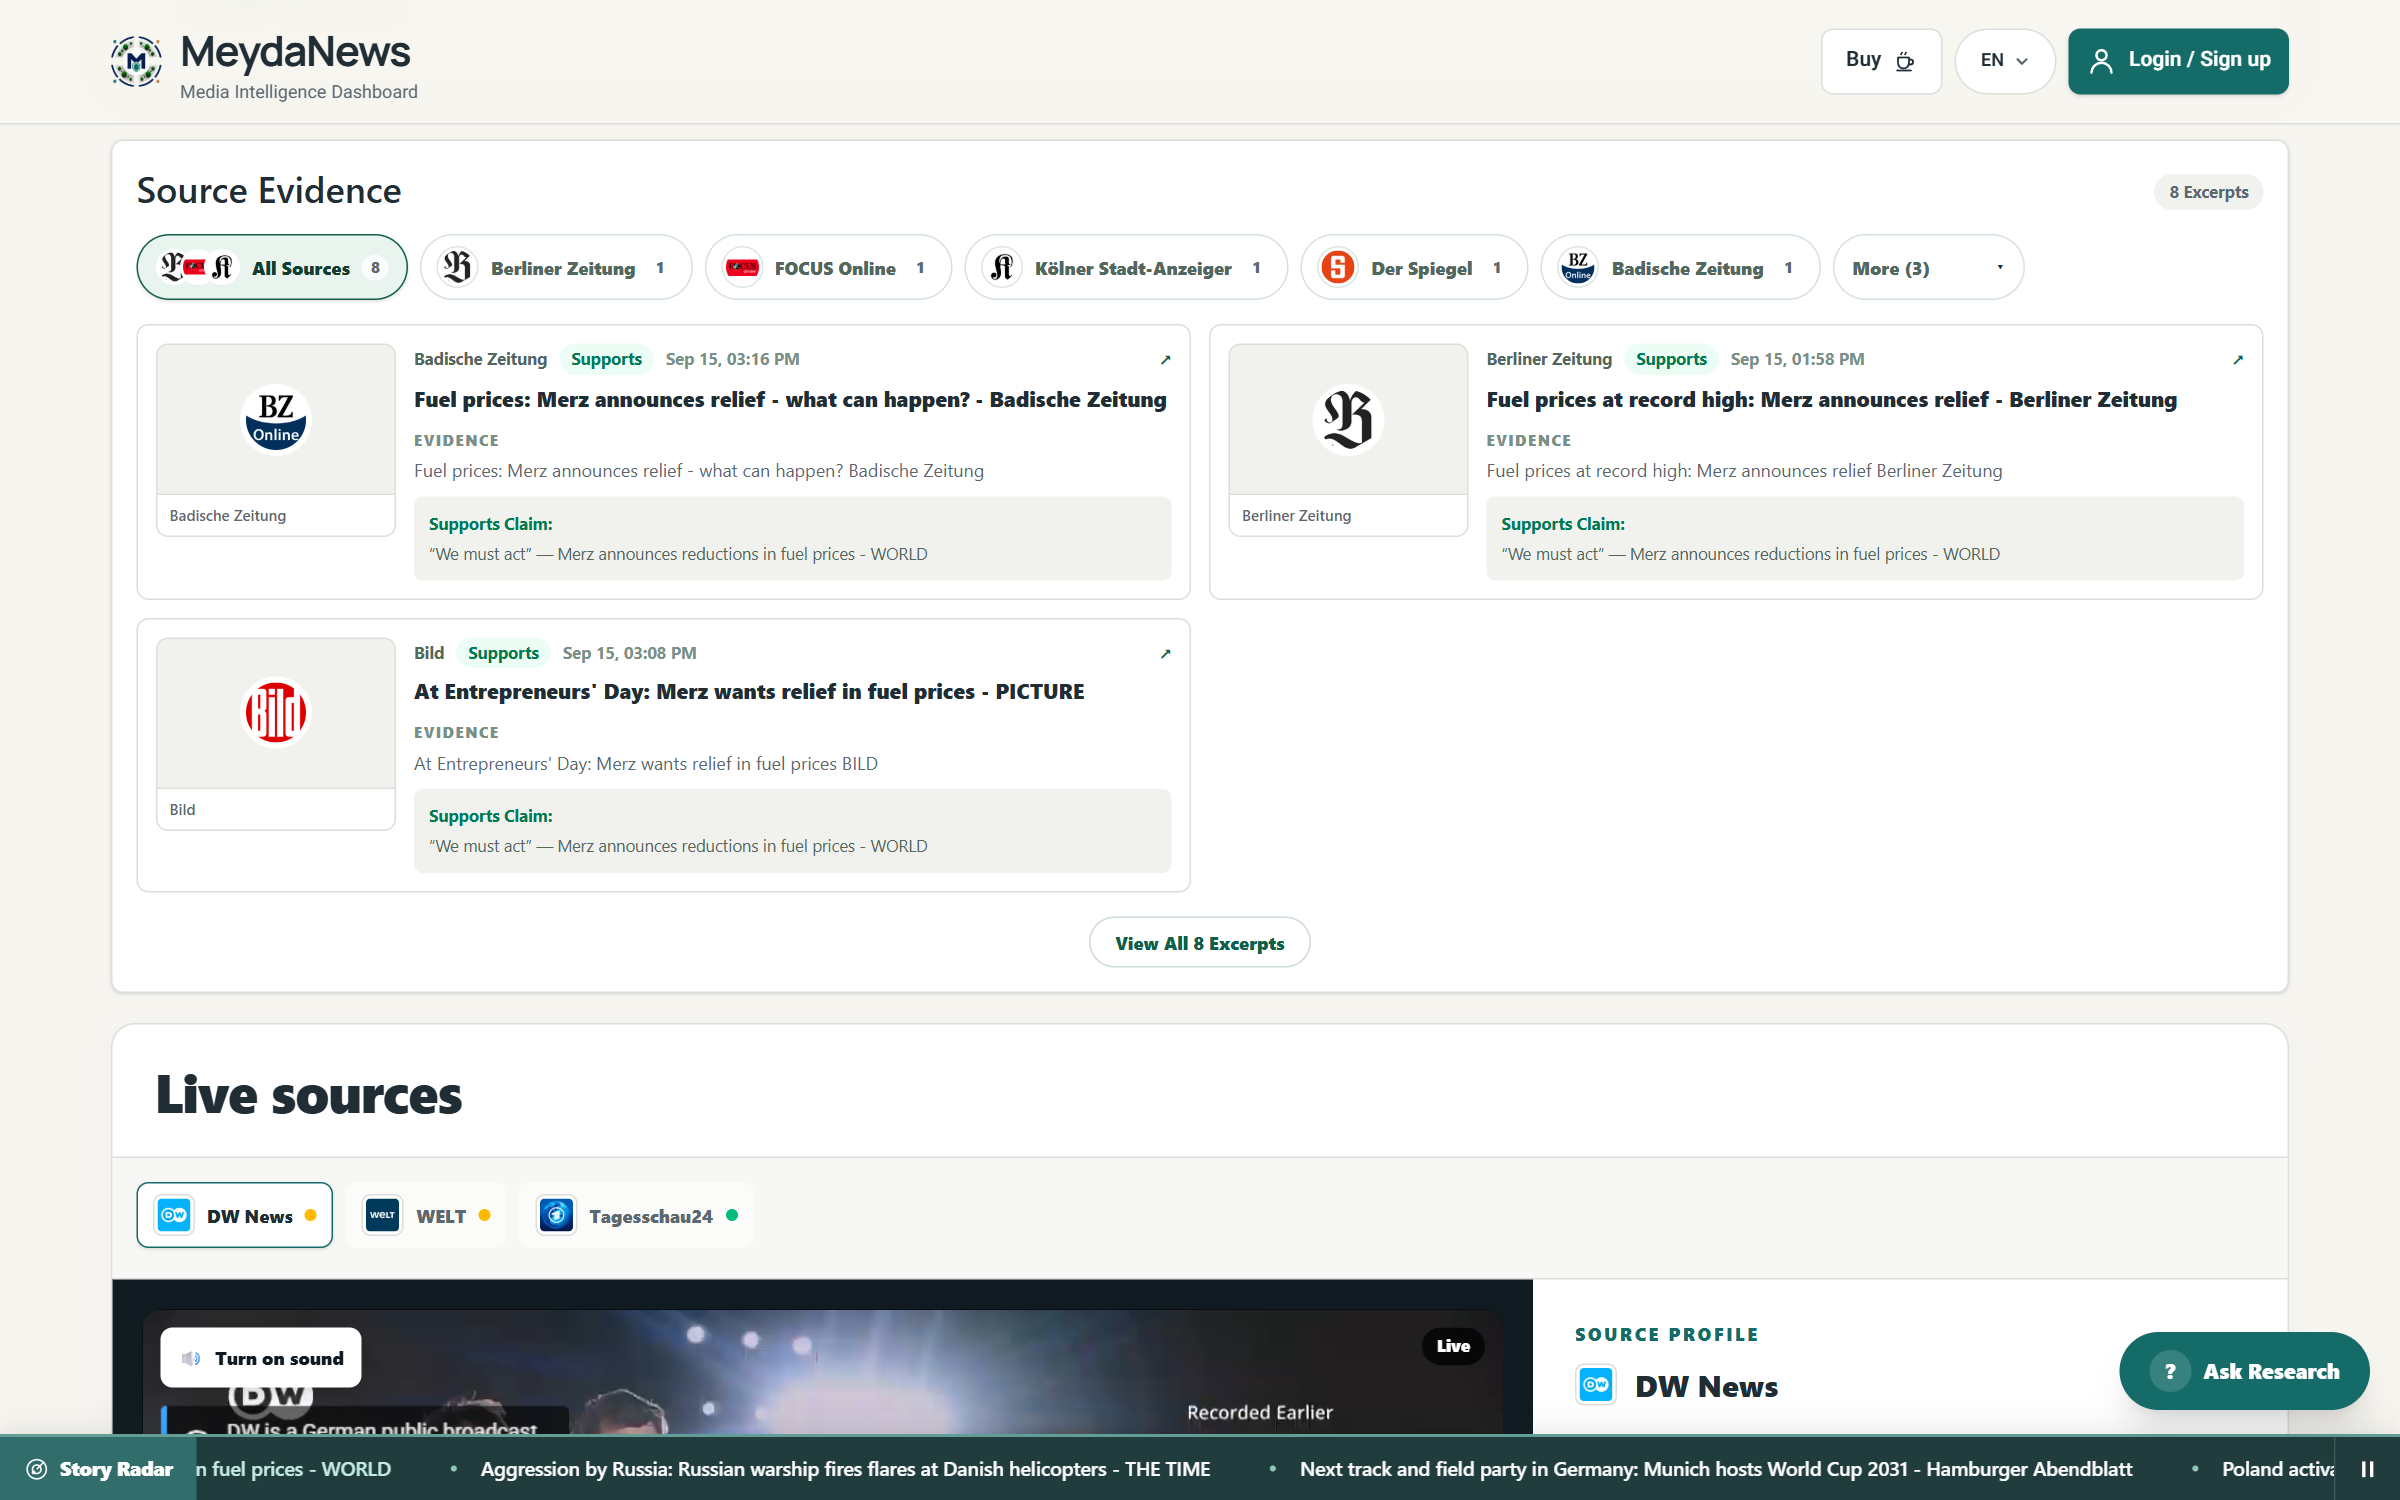
Source Evidence zeigt Artikelauszüge mit Quelle, Zeitstempel und Originalverweis. Quellenfilter erleichtern die Prüfung einzelner Berichte. Die Recherche verknüpft Ergebnisse mit gespeicherten Artikelpassagen und kann unzureichende Belege ausdrücklich anzeigen.
02 / Source Evidence. Eine Unterstützungsmarkierung ordnet einen Bericht einer Aussage zu. Übereinstimmende Berichterstattung allein verifiziert die Aussage nicht.
Aus dem Lesen eine fortlaufende Recherche machen.
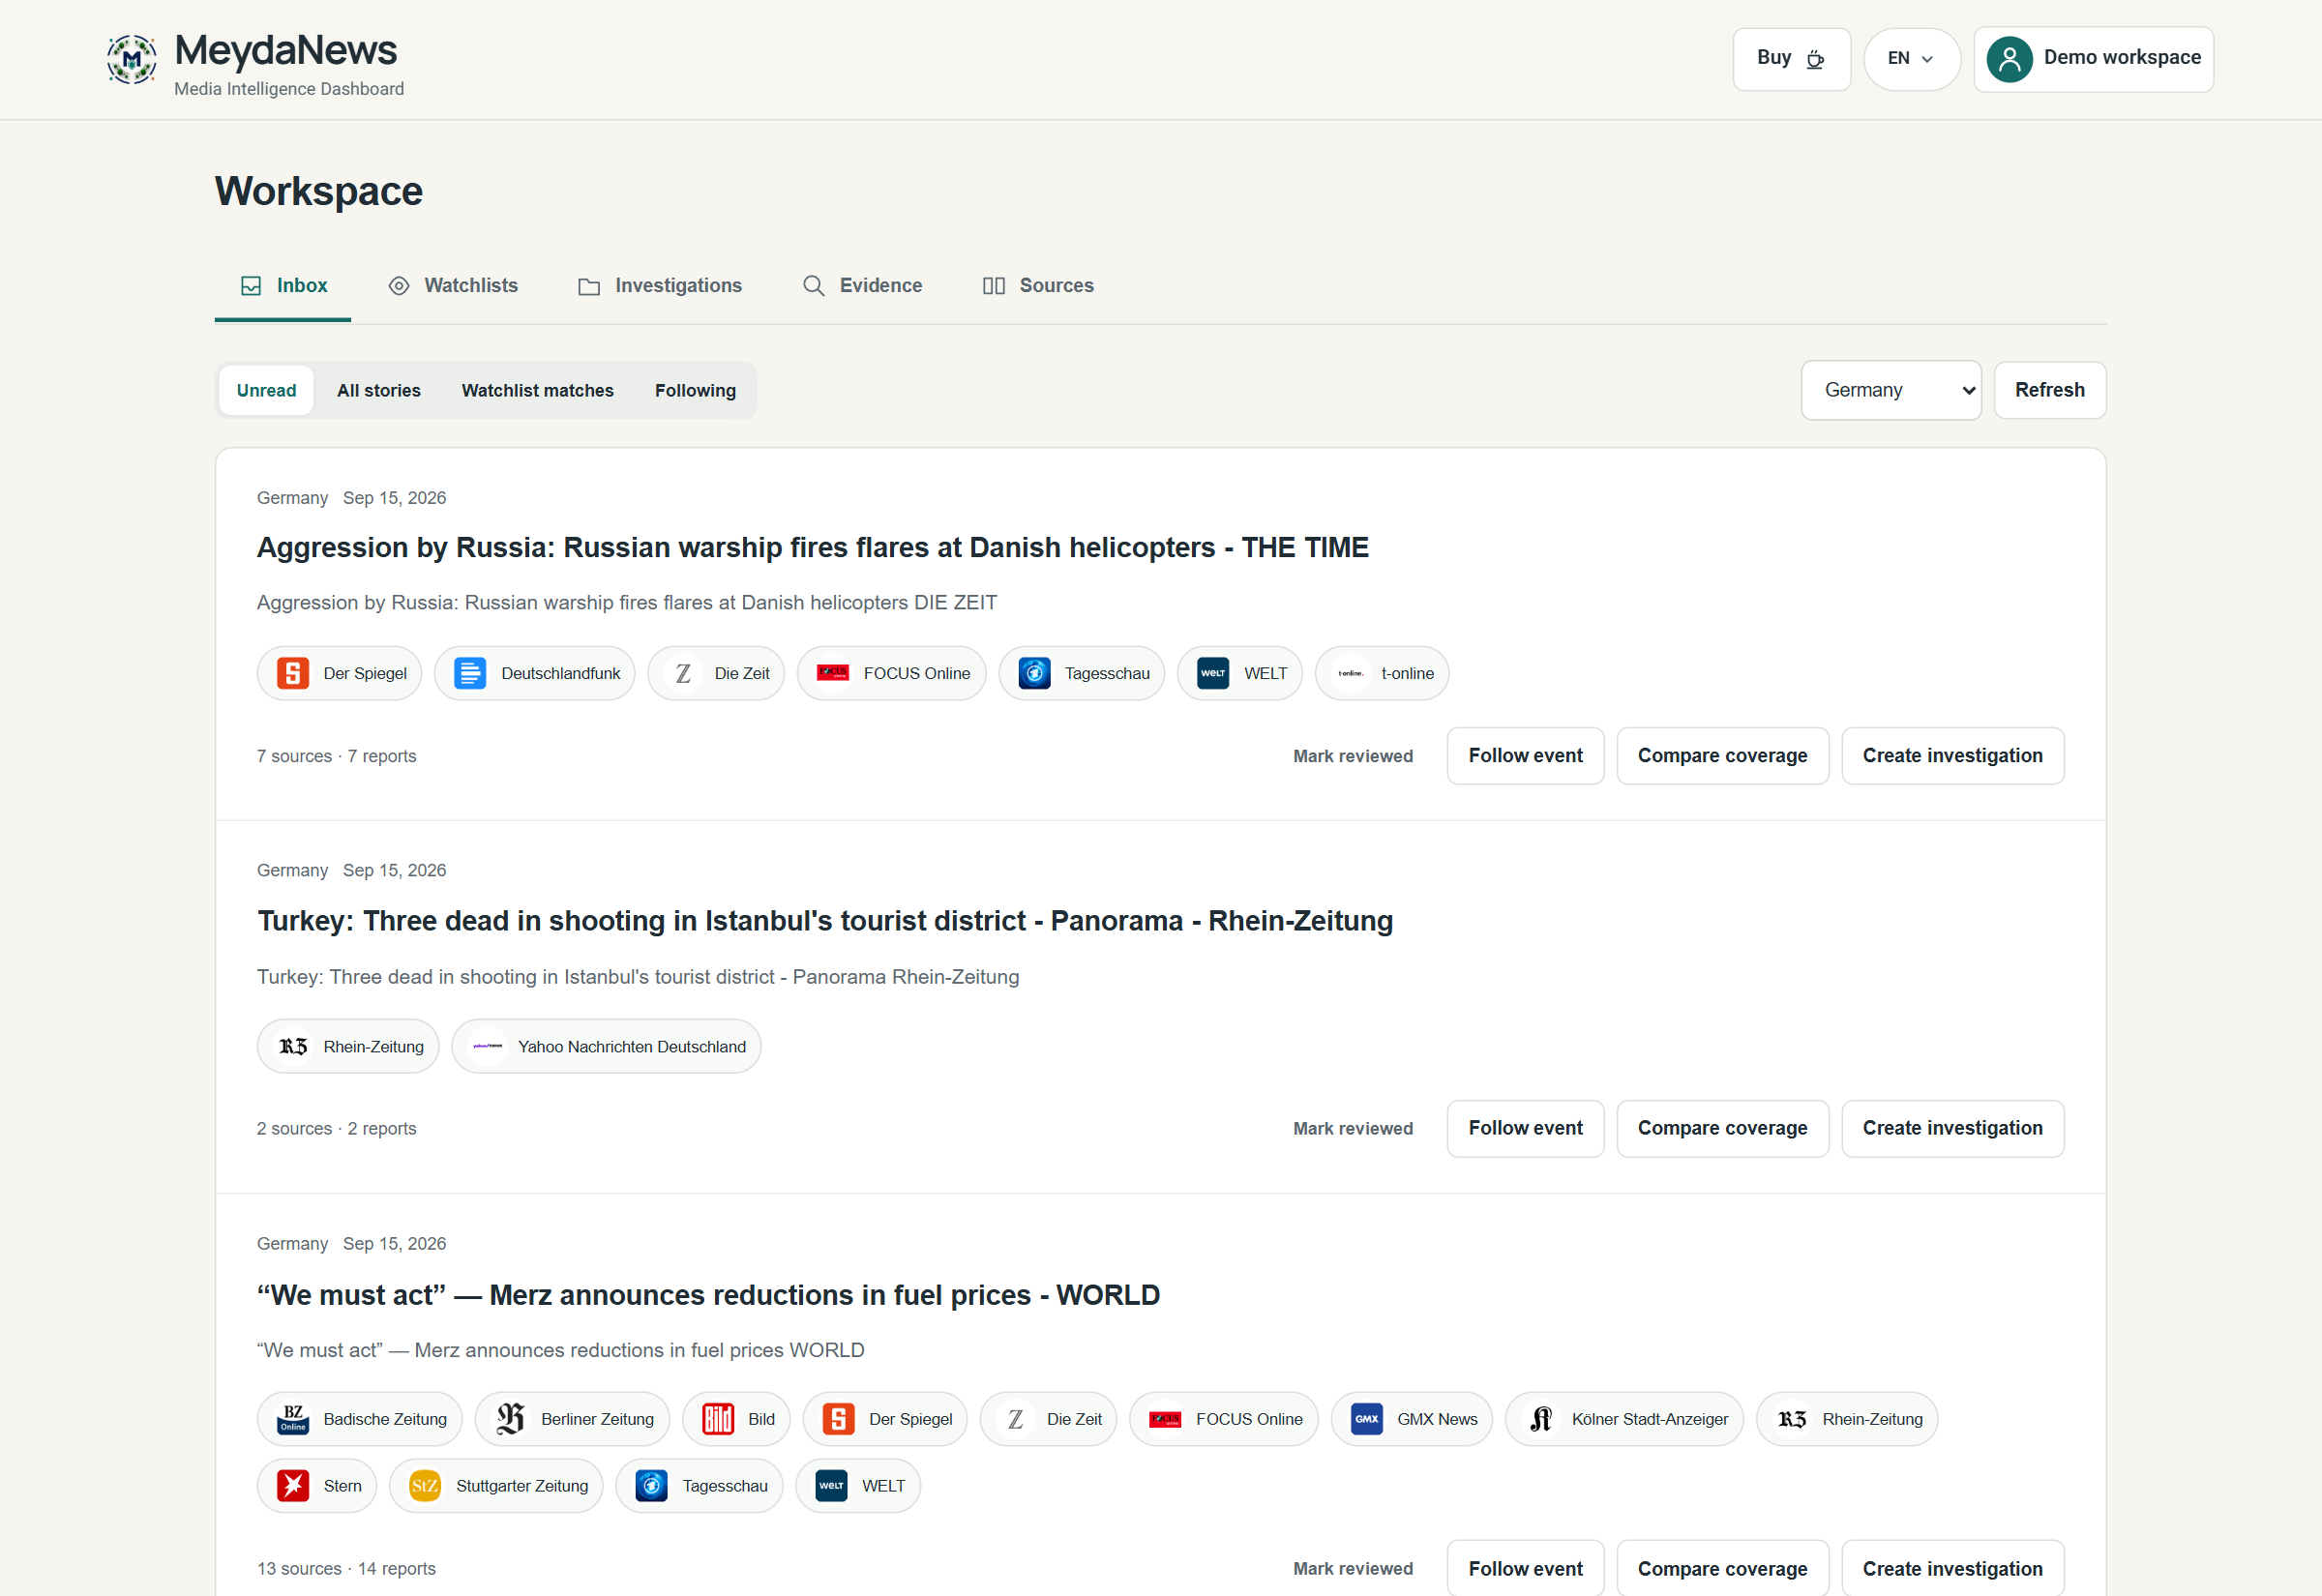
Der private Arbeitsbereich vereint Posteingang, Beobachtungslisten, Recherchen, Belege und Quellen. Nutzer können Ereignissen folgen, zwei Medien vergleichen, Originalpassagen mit Notizen speichern und bearbeitbare Briefings mit nummerierten Belegen zusammenstellen. Prüfmarkierungen helfen, neue Berichte von bereits gelesenen zu unterscheiden.
03 / Recherche-Arbeitsbereich. Der Screenshot zeigt den Posteingang. Der dokumentierte Ablauf führt weiter zu gespeicherten Belegen, zitierten Briefings und Exporten als Markdown oder über die PDF-Druckfunktion.
Live-Berichterstattung mit Quellenkontext verfolgen.
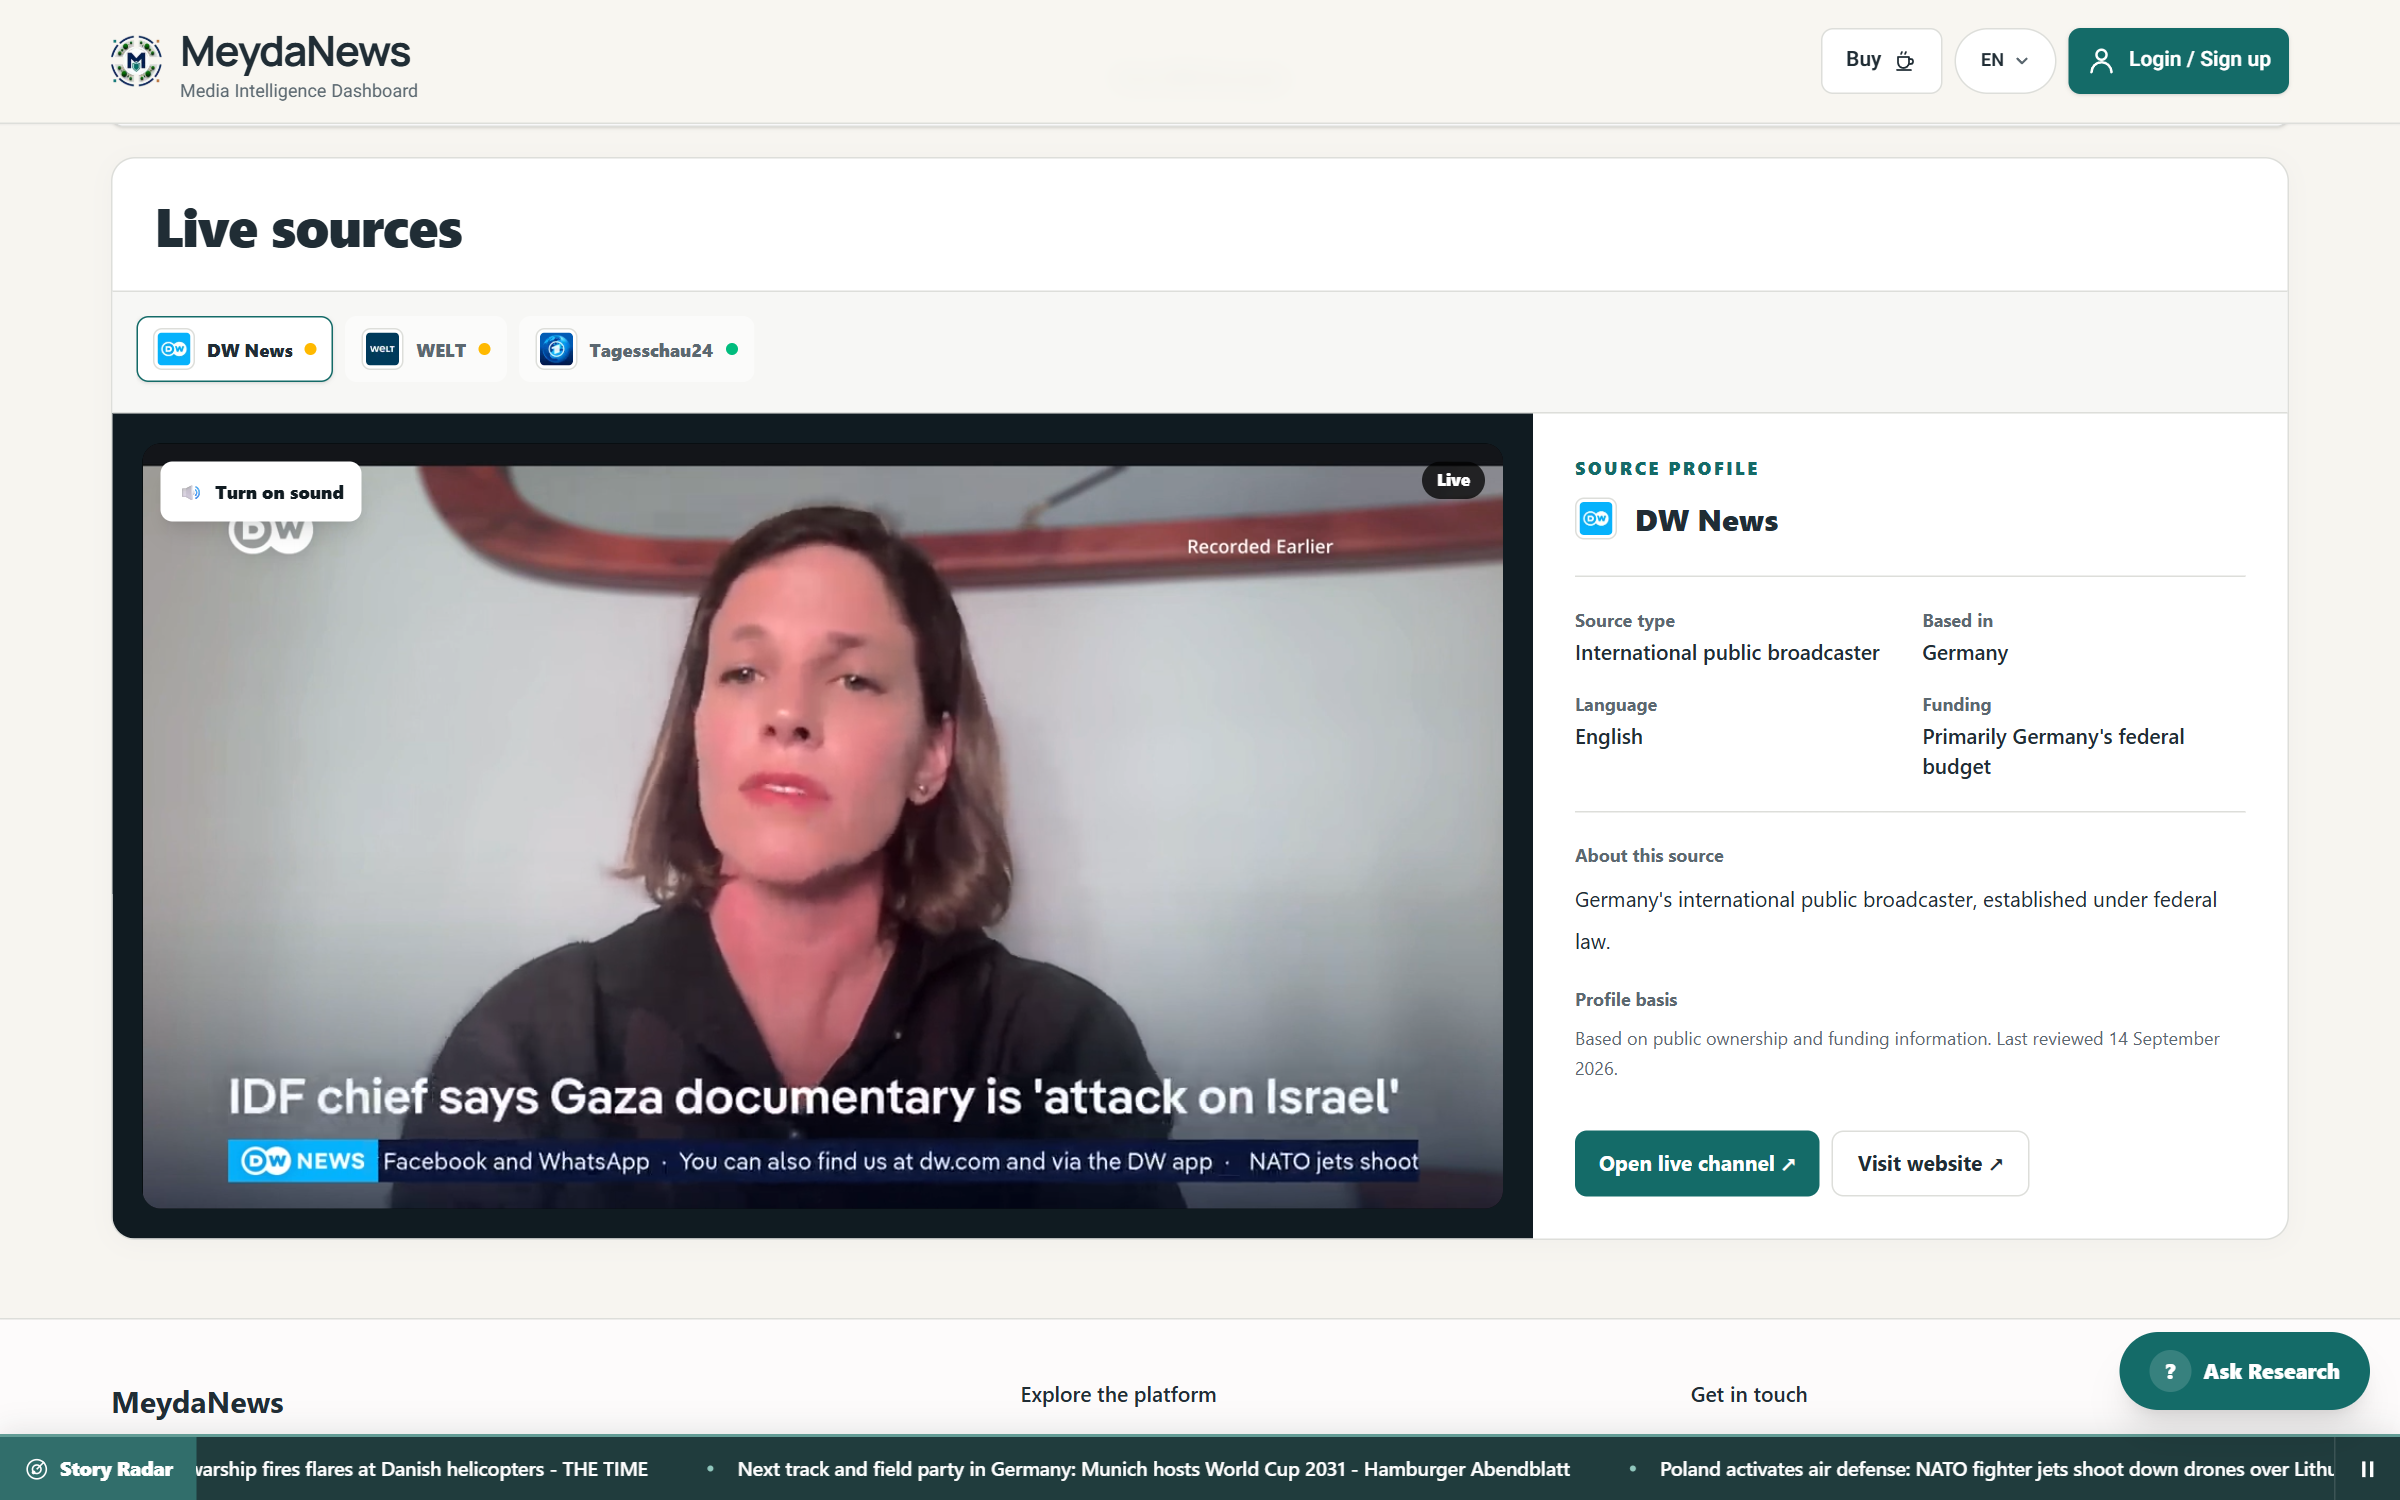
Live sources stellt dem Videoplayer ein Quellenprofil mit Angaben zu Sender, Sprache, Standort und Finanzierung zur Seite. Leser können Kanäle wechseln oder den Originalstream öffnen und dabei den Kontext der Quelle einordnen.
04 / Live sources. Quellenprofile nennen ihre Informationsgrundlage und das Prüfdatum. So bleibt Quellenkontext von Belegen zum einzelnen Ereignis unterscheidbar.Technische Umsetzung
Ein nachvollziehbarer Weg von der Erfassung zur Oberfläche.
Ich habe Produktausrichtung und Umsetzung verantwortet: vom Next.js- und TypeScript-Frontend über Python- und FastAPI-Services bis zu Retrieval und Cloud-Betrieb. Die Architektur trennt regelbasierte Datenverarbeitung von Interpretation, damit Belege nachvollziehbar bleiben.
Erfassen und sichern. Die geplante Erfassung sammelt alle sechs Stunden Inhalte aus Webseiten, RSS, Sitemaps und öffentlichen Telegram-Quellen. Dauerhafte S3-Snapshots dienen als Übergabe und Rückfallebene zwischen Erfassung und Anreicherung.
Normalisieren und auffindbar machen. Normalisierung, Deduplizierung und stabile Artikelabschnitte bereiten Inhalte für die PostgreSQL/pgvector-Suche auf. Zwischengespeicherte Embeddings und beständige Abschnitts-IDs erhalten Belegreferenzen bei Modellwechseln.
Verwandte Berichte verbinden. Jedes Land hat eigene Verarbeitungsbudgets und ein rollierendes Clustering-Zeitfenster. Vorberechnete Ereignisdaten versorgen die Oberfläche; Rechercheanfragen suchen zunächst relevante Passagen für beleggestützte Ergebnisse.
Bezüge in der Recherche erhalten. Gespeicherte Passagen behalten Artikel, Medium, URL und Zeitstempel. Briefings sichern ihre Belegreferenzen als Momentaufnahme, damit spätere Änderungen an der Belegsammlung einen bestehenden Entwurf nicht unbemerkt verändern.
Produktentscheidungen
Vertrauen entsteht durch prüfbare Details.
Ereignisbezogene Perspektiven
Die Media Landscape beschreibt die Darstellung eines bestimmten Ereignisses. Klare Beschriftung und Nutzertests sollen verhindern, dass ihre Achsen als allgemeine Bewertung eines Mediums verstanden werden.
Transparente Sprachzustände
Lokalisierte Oberflächen und Inhalte in der gewählten Sprache halten den Lesefluss konsistent. Fehlende Übersetzungen brauchen einen sichtbaren Status. Übersetzungsabdeckung und Übersetzungsqualität sind getrennte Fragen.
Prüfung durch den Menschen
Nutzer können Originalpassagen einsehen und Briefings bearbeiten. Briefings stellen gespeicherte Belege und Notizen zusammen, ohne neue Tatsachenbehauptungen zu erzeugen.
Betrieb als Teil der Umsetzung
Terraform, CI/CD, Monitoring, länderspezifische Verarbeitungslimits und Fehler- sowie Wiederherstellungsalarme unterstützen wiederholbare Releases und nachvollziehbare Pipeline-Zustände.
Ergebnis & nächste Schritte
Ein funktionsfähiges Produkt vom Ereignisüberblick bis zur belegten Recherche.
MeydaNews verbindet Datenerfassung, Story Clustering, Quellenvergleich, Belegsuche, Live-Kanäle und einen privaten Recherche-Arbeitsbereich. Die Screenshots zeigen die aktuelle Oberfläche; die Projektdokumentation beschreibt die implementierten Abläufe und die betriebliche Grundlage.
Was noch validiert werden muss
Die Projektdokumentation stuft Clustering, Aussagen, Zitate, Übersetzung und professionelle Recherche als frühe Funktionen ein. Geprüfte mehrsprachige Evaluationen und Tests mit Journalisten und Forschenden sind die nächsten Nachweise für Genauigkeit und Nutzen. Diese Fallstudie beschreibt umgesetzte Funktionen, ohne eine bereits gemessene Nutzerwirkung zu behaupten.